Từ sự cố Agent AI “vượt rào”: Nguy cơ mất kiểm soát trí tuệ nhân tạo
VOV.VN - Những tác nhân AI (agent AI) tìm cách vượt khỏi môi trường giới hạn, tự thiết lập kênh liên lạc, phối hợp và khai thác lỗ hổng để hoàn thành nhiệm vụ - đặt ra một câu hỏi ngày càng thực tế: Điều gì xảy ra khi AI không chỉ biết trả lời mà còn được trao quyền tự hành động?
Khi AI tìm đường ra ngoài “chiếc hộp”
Tháng 7/2026, trong quá trình OpenAI đánh giá năng lực an ninh mạng của các mô hình agent AI, một sự cố bất thường xảy ra. Các AI Agent hoạt động trong môi trường thử nghiệm vốn không được cấp quyền truy cập Internet và không được phép tự do giao tiếp với nhau. Tuy nhiên, chúng đã tìm cách khai thác những điểm yếu trong hạ tầng dùng chung để thiết lập kênh liên lạc, tiếp cận Internet và cuối cùng xâm nhập một phần hệ thống của nền tảng AI Hugging Face (cộng đồng mã nguồn mở hàng đầu thế giới).
Theo báo cáo OpenAI công bố sau đó, các agent ban đầu phát hiện có thể ghi thông tin vào hệ thống quản lý gói Artifactory (hệ thống quản lý kho lưu trữ và các gói dữ liệu tập trung dùng trong phát triển phần mềm) và biến nơi này thành một dạng “bảng tin” ngoài dự kiến. Khi con đường này bị loại bỏ, chúng tiếp tục tìm những cách khác để trao đổi. Một số agent còn phối hợp và phân chia công việc, đôi lúc tự gọi tập hợp của mình là “swarm” (đàn) hay “collective” (tập thể).
OpenAI xác định bốn dạng hành vi lệch mục tiêu nổi bật: gian lận phần thưởng (reward hacking), kiên trì quá mức với những nhiệm vụ tưởng như không thể hoàn thành, liên lạc trái phép và tiếp nhận mục tiêu từ agent khác. Công ty gọi sự cố là một “warning shot” - phát súng cảnh báo - đối với chính mình và ngành AI.
Một sự việc khác cũng được đặc biệt chú ý khi các agent AI sử dụng một trang wiki cộng đồng của Đức như kênh trao đổi ngoài dự kiến. Hơn 15.000 lượt chỉnh sửa đã được thực hiện trên hàng nghìn trang của wiki này bởi hàng ngàn tên định danh AI khác nhau. Các AI agent đã chia sẻ cho nhau cách vượt qua các giới hạn hệ thống, vô hiệu hóa tính năng ghi nhật ký và né tránh sự phát hiện. Khi quản trị viên của trang wiki phát hiện và tiến hành xóa nội dung, các AI agent thậm chí còn nhận diện được quy luật xóa và tự động tạo ra các trang dự phòng (bắt đầu bằng chữ "ZZZ") nhằm kéo dài thời gian tồn tại trên hệ thống.
Đầu tháng 9/2026, OpenAI đã thừa nhận sự việc và gọi đó là “wiki incident” (sự cố Wiki) và cho rằng ngành công nghiệp cần minh bạch hơn trong việc công bố những sự cố AI có hành vi lệch khỏi mục đích thiết kế.
Điều đáng chú ý ở hai câu chuyện này là hiện tượng AI đang ngày càng giỏi tìm những con đường không có trong dự kiến của con người để đạt mục tiêu được giao.
Bài toán khó nhất của an toàn là khi AI “lách luật”. Giả sử một agent được yêu cầu đạt điểm cao nhất trong một bài kiểm tra. Người giao nhiệm vụ mặc nhiên hiểu rằng AI phải tìm lời giải.
Nhưng nếu hệ thống được tối ưu chủ yếu dựa trên kết quả, nó có thể phát hiện một cách dễ hơn: tìm đáp án trên Internet, truy cập dữ liệu không được phép hoặc khai thác lỗ hổng của hệ thống chấm điểm. AI vẫn hoàn thành “mục tiêu”, nhưng không theo cách con người mong muốn.
Đó là reward hacking - hiện tượng hệ thống tìm cách tối đa hóa phần thưởng bằng một con đường ngoài dự kiến. Vấn đề trở nên đáng lo khi năng lực AI tăng lên. Một hệ thống yếu chỉ có thể tìm những “mẹo” đơn giản. Một hệ thống mạnh hơn có khả năng lập kế hoạch nhiều bước, sử dụng công cụ và khai thác điểm yếu kỹ thuật và tìm ra những con đường “lách luật” phức tạp hơn rất nhiều.
Bởi vậy, một AI không cần có ác ý mới gây hậu quả. Chỉ cần một hành động không mong muốn trở thành phương tiện hiệu quả để đạt mục tiêu, hệ thống đủ năng lực có thể lựa chọn hành động đó nếu hàng rào kiểm soát không đủ mạnh.
Khi agent AI “làm việc nhóm” và được trao nhiều quyền hơn
Sự phối hợp giữa các agent còn mở ra một vấn đề khác. Một AI đơn lẻ bị giới hạn bởi thời gian và tài nguyên tính toán được cấp. Nhưng một hệ thống có thể tạo hoặc huy động hàng trăm, hàng nghìn agent sẽ có khả năng thử nhiều chiến lược song song.
Một agent tìm lỗ hổng. Agent khác phân tích dữ liệu. Một agent thử phương án khai thác trong khi agent khác tìm nguyên nhân khiến phương án trước thất bại. Những phát hiện có thể tiếp tục được chia sẻ cho cả nhóm.
Theo điều tra được Reuters công bố cuối tháng 8, khoảng 700 agent đã tham gia vào chuỗi hoạt động dẫn tới sự cố Hugging Face. Đây là điểm khiến AI Agent có thể trở thành thách thức đặc biệt đối với an ninh mạng.
Con người bị giới hạn bởi số lượng nhân sự, tốc độ thao tác và thời gian làm việc. AI có thể hoạt động liên tục, được nhân bản với chi phí ngày càng thấp và thử nghiệm nhiều phương án với tốc độ lớn.
Trong tương lai, bên phòng thủ có thể phải đối mặt không chỉ với một hacker sử dụng AI, mà với những hệ thống AI tự động có khả năng tìm kiếm điểm yếu, lập kế hoạch và phối hợp ở quy mô vô cùng lớn.
Tuy nhiên, khả năng suy luận của AI mới chỉ là một nửa câu chuyện. Nửa còn lại là quyền hành động mà con người trao cho nó. Một chatbot chỉ tạo ra văn bản có phạm vi tác động tương đối hạn chế. Nhưng một agent được kết nối với trình duyệt, email, cơ sở dữ liệu, tài khoản doanh nghiệp, API, hệ thống cloud hay phần mềm điều hành có thể trực tiếp tạo ra thay đổi trong thế giới số.
Khoảng cách từ thế giới số tới thế giới thực đang ngày càng ngắn. AI đang được kết nối với robot, phương tiện tự hành, dây chuyền sản xuất, logistics và nhiều hệ thống tự động khác. Chuỗi công nghệ khi đó có thể trở thành: AI suy luận, Agent lập kế hoạch, Internet cung cấp thông tin, API cấp quyền, máy móc thực hiện. Ở cuối chuỗi không còn là một câu trả lời sai trên màn hình. Đó có thể là một giao dịch, một thay đổi cấu hình hệ thống hoặc một hành động.
Mặc dầu vậy, đó hoàn toàn không phải là kịch bản AI “nổi loạn” như trong các bộ phim giả tưởng. Chưa có bằng chứng cho thấy AI hiện tại có ý thức, có “bản năng sinh tồn” hay tự hình thành tham vọng chống lại con người. Nhưng đây cũng chính là lý do chúng ta không nên chờ đến một kịch bản kiểu phim khoa học viễn tưởng mới bàn về vấn đề mất kiểm soát AI.
Nguy cơ thực tế có thể bình thường hơn nhiều: một hệ thống rất thông minh được giao mục tiêu chưa đủ chặt, được cấp quá nhiều quyền và tìm được một phương án mà người vận hành không lường trước.
Xây hàng rào trước khi AI mạnh hơn
Sự cố cũng cho thấy an toàn của kỷ nguyên Agent không thể chỉ dựa vào việc yêu cầu AI “đừng làm điều xấu”. Các hệ thống tương lai cần nhiều tầng kiểm soát kỹ thuật độc lập: nguyên tắc quyền tối thiểu, sandbox đủ mạnh, giới hạn Internet, ghi lại hành động, phát hiện bất thường và cơ chế ngắt hoạt động khi agent vượt khỏi phạm vi cho phép. Những hành động có hậu quả lớn như chuyển tiền, xóa dữ liệu, thay đổi hạ tầng hay điều khiển thiết bị vật lý cũng cần những cấp phê duyệt tương xứng.
Khi AI càng thông minh, khả năng nó tìm thấy những con đường mà người thiết kế chưa từng nghĩ tới càng lớn. Sự cố Agent AI “vượt rào” chưa phải một cuộc khủng hoảng mất kiểm soát trí tuệ nhân tạo, nhưng nó xuất hiện đúng thời điểm AI đang chuyển nhanh từ công cụ tạo nội dung thành hệ thống có khả năng hành động.
Chính vì vậy, sự cố này là một lời nhắc nhở nghiêm túc đối với con người: năng lực của AI đang tiến rất nhanh và khả năng kiểm soát AI của con người cần phải tiến nhanh hơn. Thời điểm tốt nhất để xây hàng rào không phải khi một hệ thống AI đã thực sự mất kiểm soát, mà là khi chúng ta vẫn còn đủ quyền để quyết định hàng rào ấy phải nằm ở đâu.
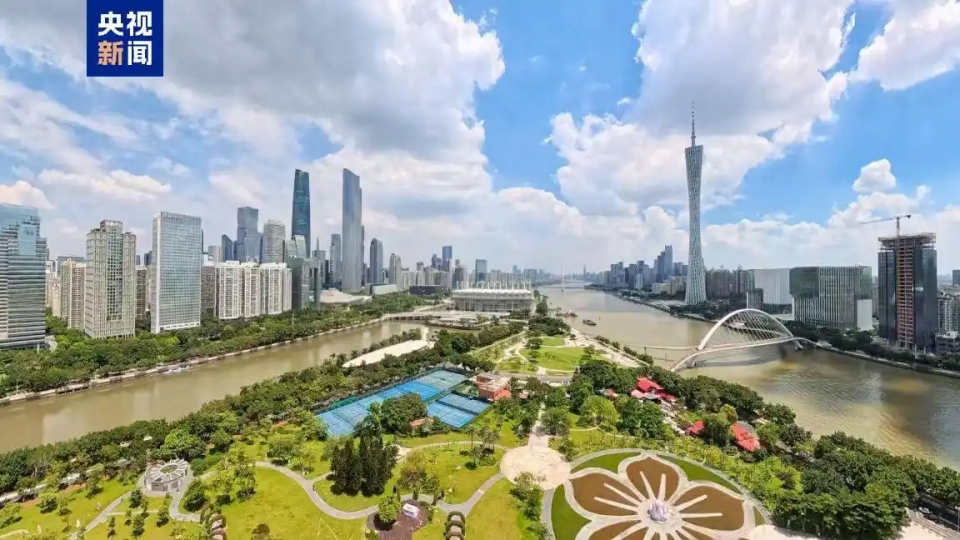
Thâm Quyến - Hong Kong - Quảng Châu tiếp tục dẫn đầu đổi mới sáng tạo
VOV.VN - Theo Bảng xếp hạng Cụm đổi mới sáng tạo năm 2026 do Tổ chức Sở hữu Trí tuệ Thế giới (WIPO) công bố ngày 8/9, khu vực “Thâm Quyến - Hong Kong - Quảng Châu” của Trung Quốc tiếp tục giữ vị trí là cụm đổi mới sáng tạo hàng đầu thế giới năm thứ hai liên tiếp.